Moteur de recherche d’emploiJob search engineEn ligneLive
JobMapAI
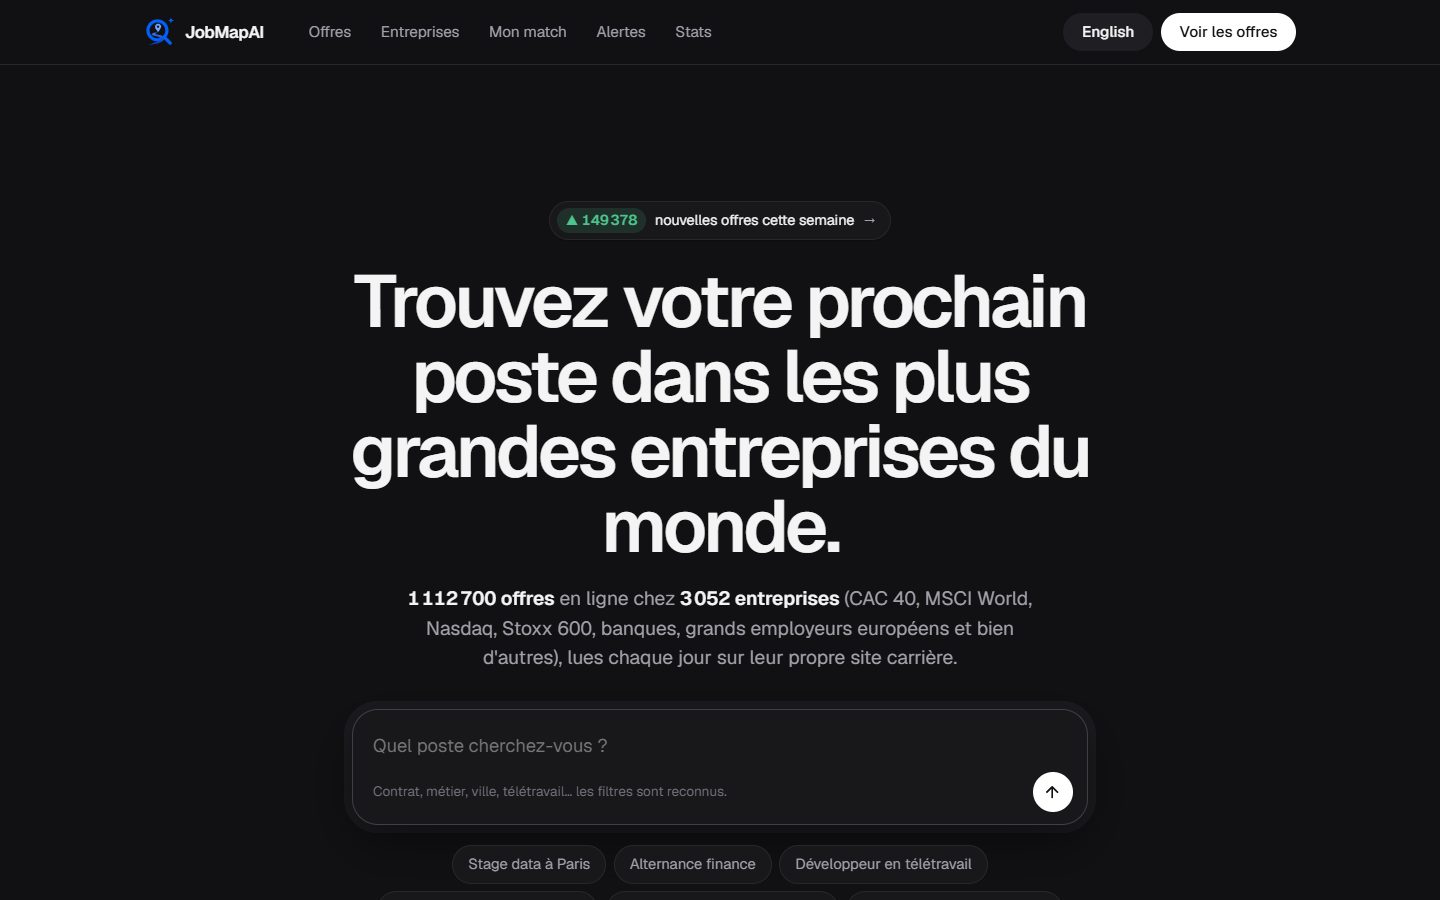
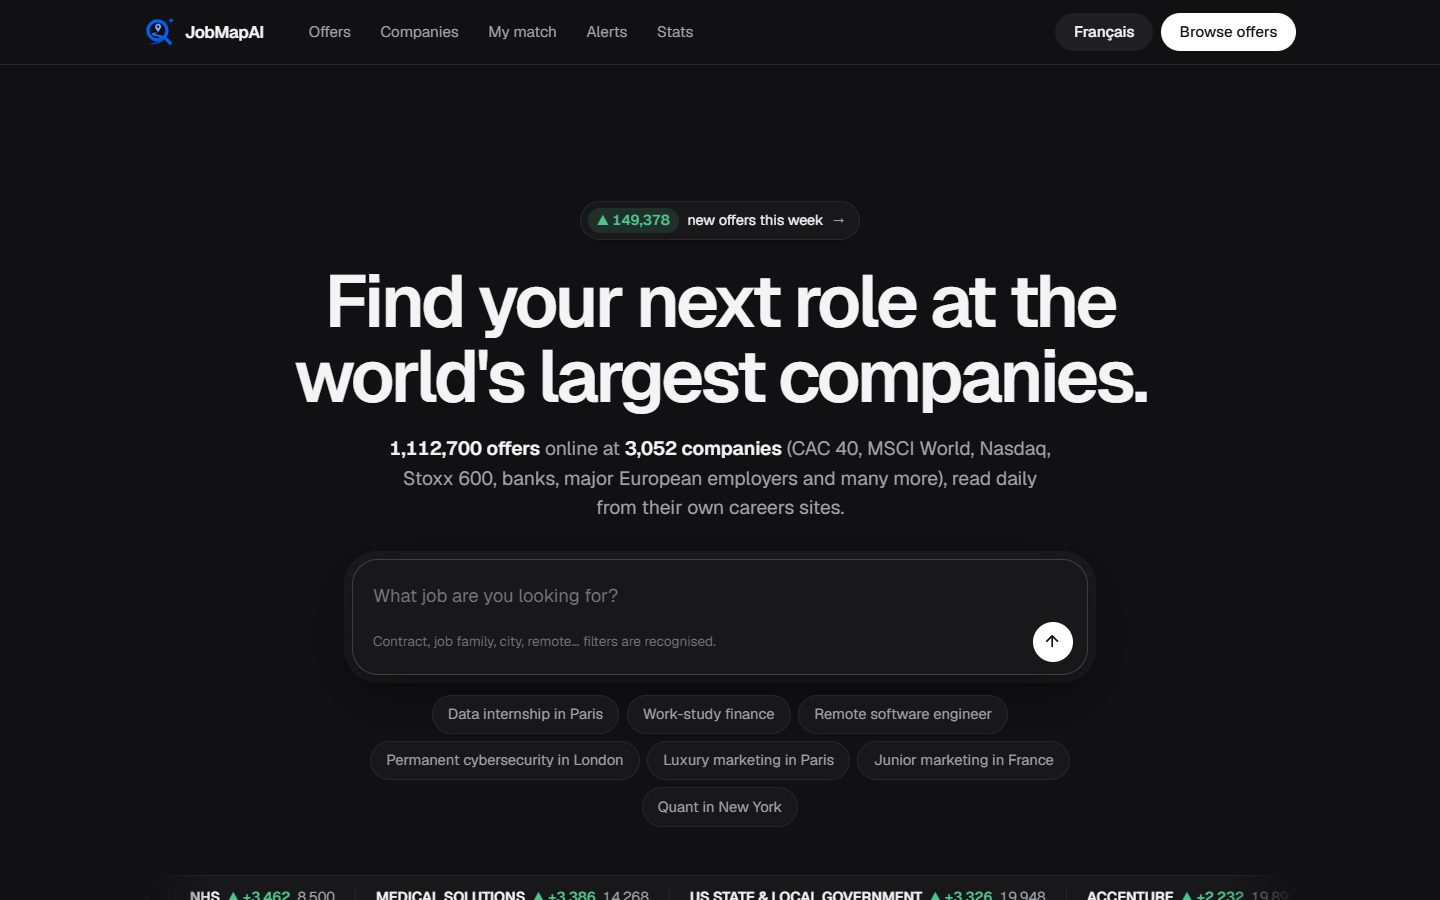
Les offres d’emploi de 3 052 grandes entreprises, lues chaque jour directement sur leurs sites carrière, classées et réunies dans un seul moteur de recherche.
Job offers from 3,052 large companies, read every day straight from their own careers sites, classified and gathered in a single search engine.
- offres en ligneoffers online
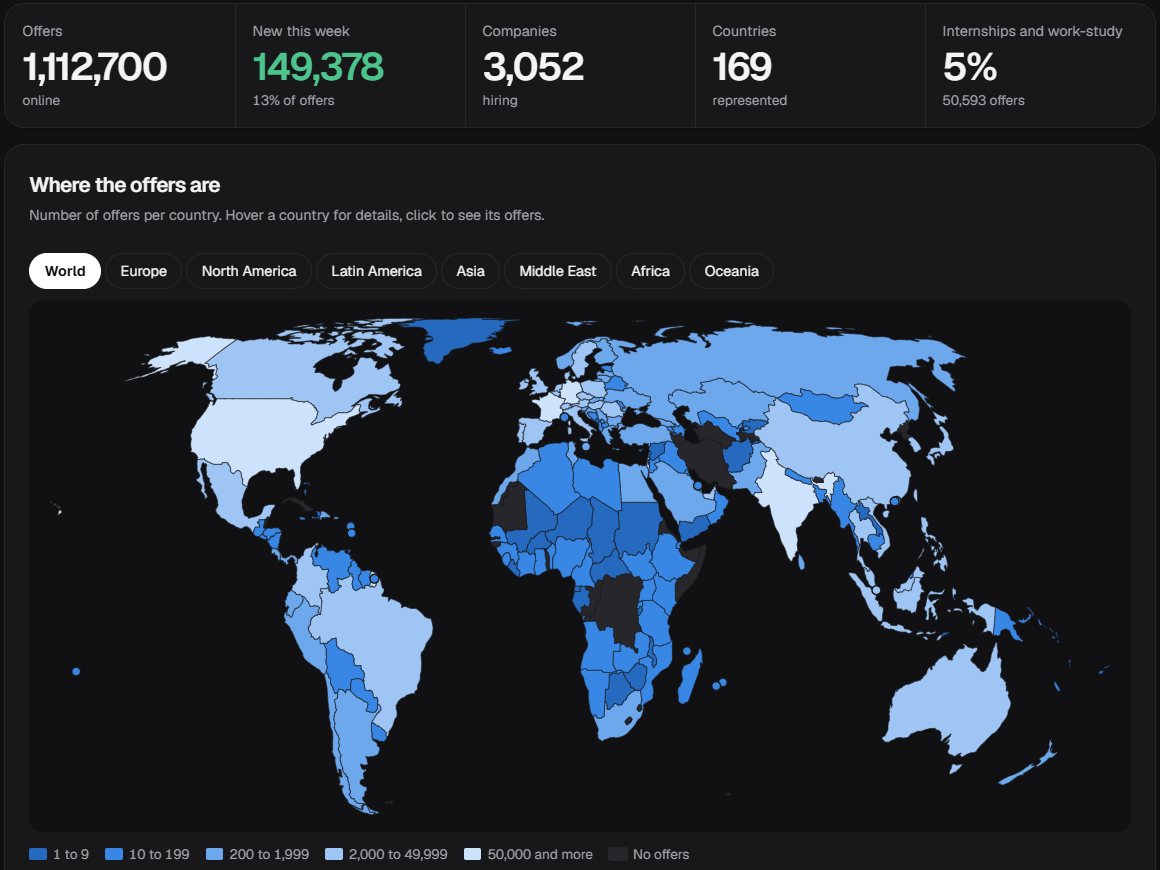
- 1 112 7001,112,700
- nouvelles cette semainenew this week
- ▲ 149 378149,378
- entreprises suiviescompanies tracked
- 3 0523,052
- payscountries
- 169
- villescities
- 51 14951,149
Ce que ça faitWhat it does
- Scraping quotidien des sites carrière du CAC 40, des grandes banques, du MSCI World, du Nasdaq et du Stoxx Europe 600.
- Chaque offre est nettoyée puis classée : métier, technologies, contrat, niveau, pays et ville, télétravail, langue, salaire quand il est publié, sponsoring de visa.
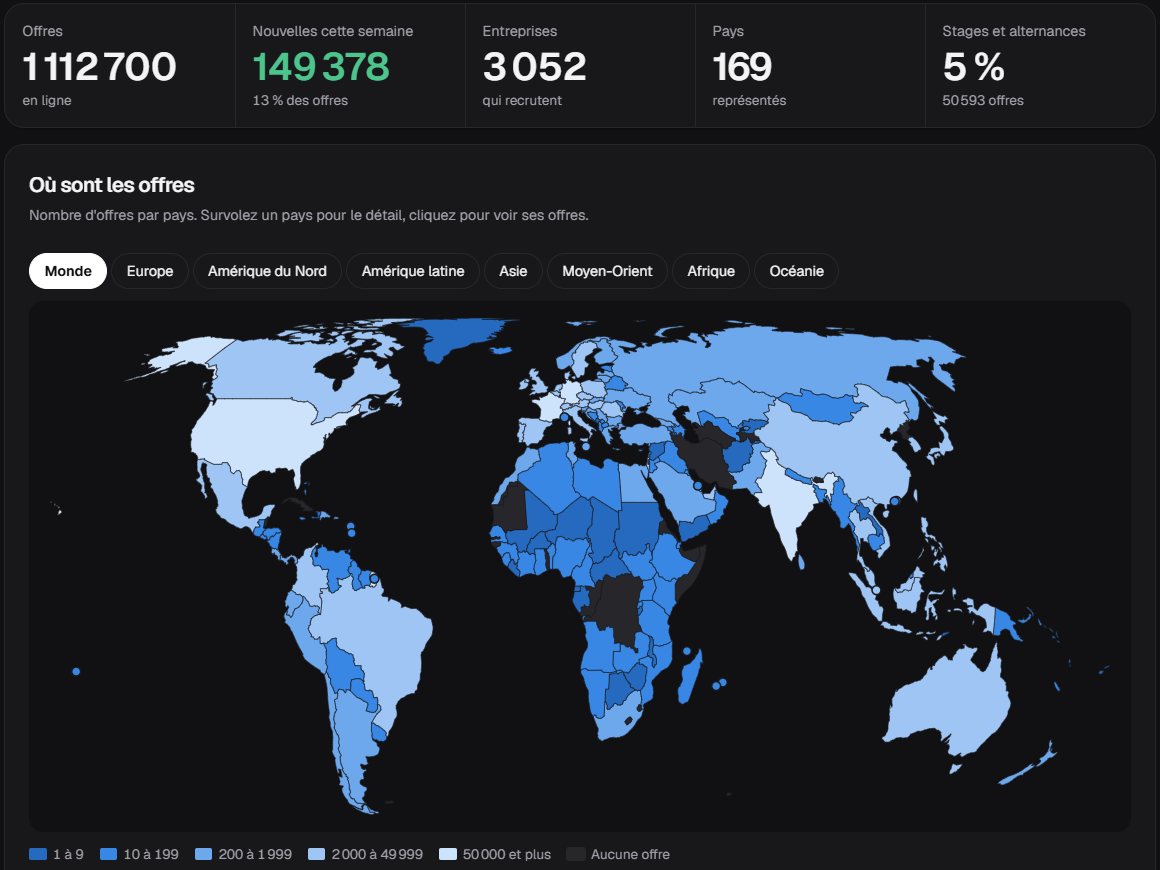
- Recherche à facettes, pages entreprise et statistiques : carte du monde, profil de recrutement de chaque entreprise, heatmap compétences × entreprises. En anglais et en français.
- « Mon match » : on décrit ce qu’on cherche en une phrase, un LLM en tire un profil structuré, puis chaque offre reçoit un score (lieu 35, poste 30, compétences 15, niveau 12, contrat 8).
- Daily scraping of the careers sites of the CAC 40, major banks, the MSCI World, the Nasdaq and the Stoxx Europe 600.
- Every offer is cleaned and classified: job family, technologies, contract, level, country and city, remote policy, language, salary when published, visa sponsorship.
- Faceted search, company pages and statistics: a world map, each company’s hiring profile, a skills × companies heatmap. In English and French.
- “My match”: describe what you want in one sentence, an LLM turns it into a structured profile, then every offer gets a score (location 35, role 30, skills 15, level 12, contract 8).
- Une base class de scraper par ATS (Workday, SuccessFactors, Oracle HCM, Greenhouse, iCIMS, Eightfold, Phenom…) : une nouvelle entreprise tient souvent en dix lignes.
- 20 entreprises scrapées en parallèle, mode incrémental, retries avec backoff sur les erreurs 429 et 503, plafond de 2 000 résultats de Workday contourné par découpage en facettes. Playwright pour les sites en JavaScript ou protégés.
- Historique dans SQLite, API servie par DuckDB qui calcule les facettes côté serveur, pages statiques sans aucune dépendance hébergées sur Cloudflare.
- Une VM Oracle Cloud gratuite (ARM, Ubuntu) fait tout tourner : deux crons par jour, backup quotidien de la base, HTTPS par Caddy. Recherche sémantique par embeddings, LLM Qwen servi par Ollama.
- One scraper base class per ATS (Workday, SuccessFactors, Oracle HCM, Greenhouse, iCIMS, Eightfold, Phenom…): adding a company often takes ten lines.
- 20 companies scraped in parallel, incremental runs, retries with backoff on 429 and 503 errors, Workday’s 2,000-result cap bypassed by splitting on facets. Playwright for JavaScript-heavy or protected sites.
- History in SQLite, an API served by DuckDB that computes facets server-side, and dependency-free static pages hosted on Cloudflare.
- A free Oracle Cloud VM (ARM, Ubuntu) runs everything: cron twice a day, daily database backups, HTTPS through Caddy. Semantic search with embeddings, and a Qwen LLM served by Ollama.
- Python
- Playwright
- requests
- BeautifulSoup
- lxml
- pandas
- SQLite
- DuckDB
- NumPy
- Ollama
- Qwen 3.5
- embeddinggemma
- Vanilla JavaScript
- Oracle Cloud
- Cloudflare Workers
- Caddy
- systemd
- cron
- xvfb